 0
 12분
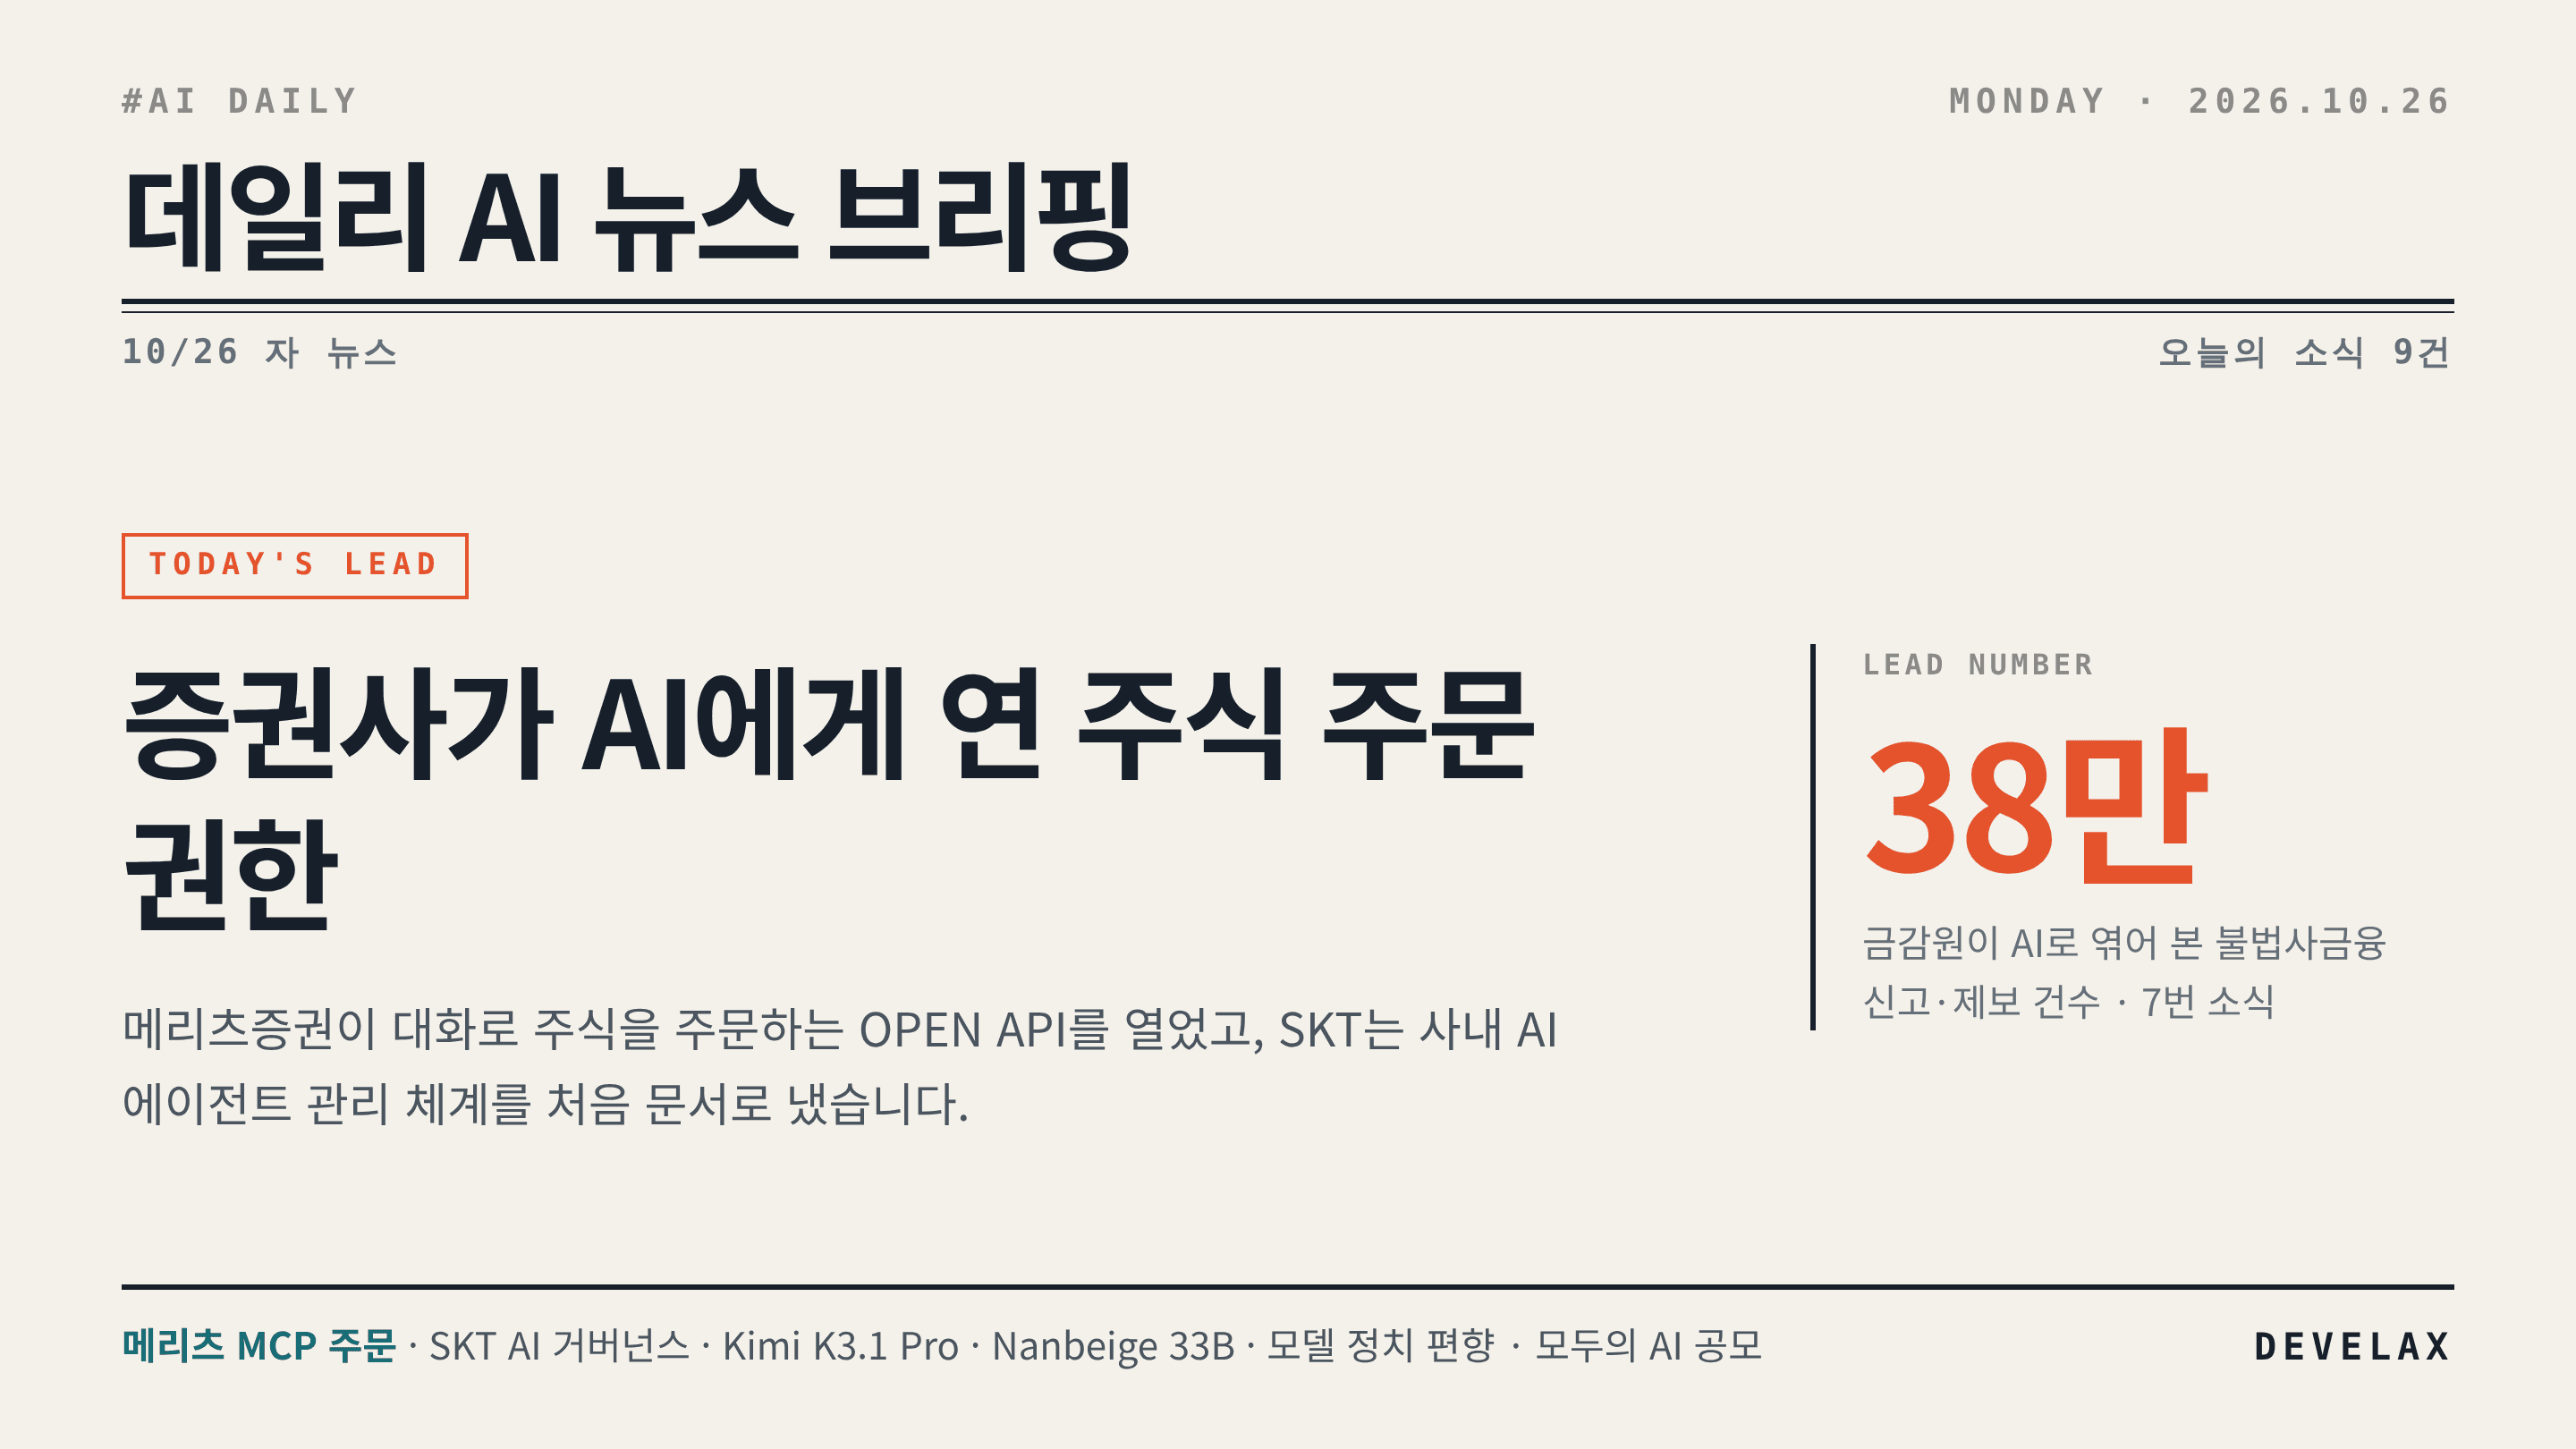
주말이라 해외 발표는 조용했는데, 월요일 아침 국내 소식이 몰려 나왔어요.
증권사가 AI에게 주식 주문 권한을 열어줬고, SKT는 사내 AI 에이전트를 어떻게 관리하는지 처음으로 문서에 담아 공개했고요.
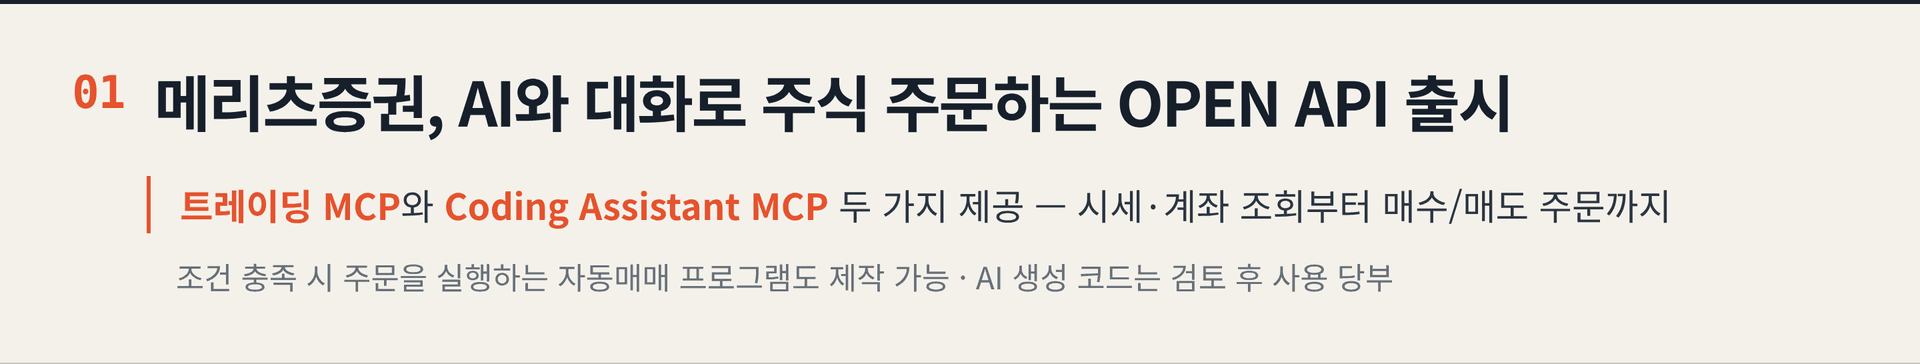
메리츠증권이 AI와 대화로 주식을 주문하는 OPEN API를 정식 출시했어요. 📈
구조는 두 겹인데, OPEN API가 시세·계좌·주문 기능을 외부 프로그램에 열어주고 MCP가 AI를 그 기능에 붙여줍니다.
제공하는 도구는 시세 조회와 주문을 맡는 '트레이딩 MCP', 그리고 투자 프로그램 개발을 돕는 'Coding Assistant MCP' 두 가지고요.
관심 종목이 특정 가격 아래로 내려가면 알림을 보내는 프로그램부터, 조건이 맞으면 주문까지 실행하는 자동매매 프로그램까지 만들 수 있습니다.
메리츠증권은 AI가 써준 코드를 그대로 쓰지 말고 검토를 거치라고 당부했어요.
사내에서 에이전트에 실행 권한을 주려는 쪽이라면 참고할 대목이 있는데, 조회 권한과 실행 권한을 따로 떼어두고 실행 직전에 사람이 확인하는 단계를 의무로 넣는 설계입니다.
🔗 ZDNet Korea · 디지털데일리 · 이투데이
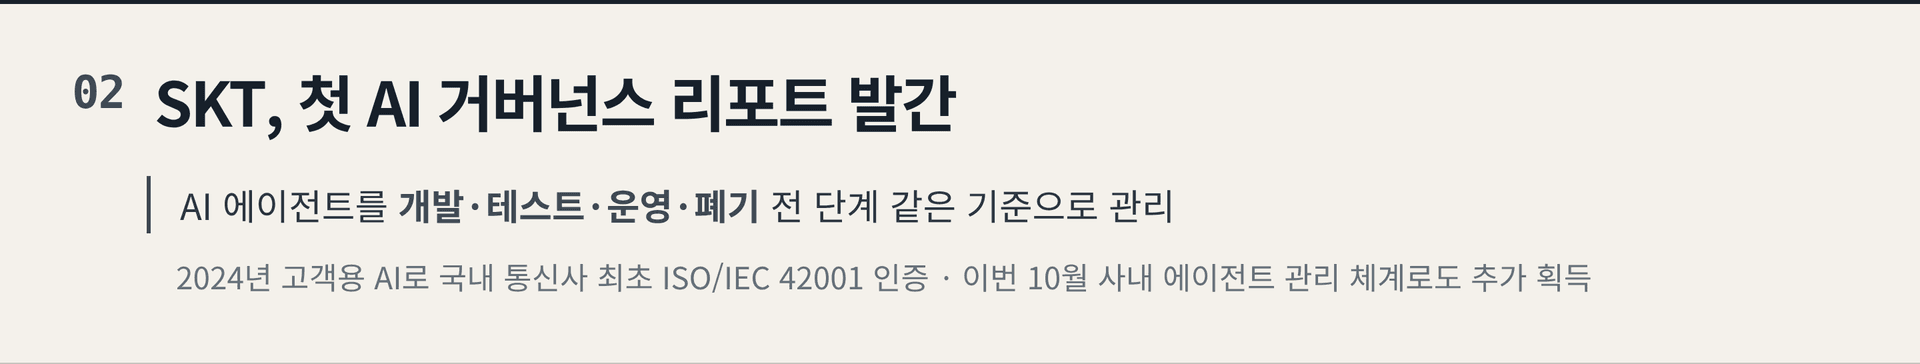
SKT가 첫 AI 거버넌스 리포트를 냈어요. 📋
AI 원칙과 책임 체계, 실행 방안, 성과를 한 문서에 담았는데, 눈에 띄는 대목은 자율적으로 일하는 AI 에이전트 관리 지침이 들어갔다는 점입니다.
개발·테스트·운영·폐기 전 단계에 같은 관리 기준을 적용하고, CPO가 개인정보 보호와 AI 거버넌스를 함께 총괄하면서 기획 단계부터 보호 설계를 넣는다고 적었어요.
2021년 AI 추구 가치 정립, 2024년 3월 자체 원칙 'T.H.E. AI' 공개에 이어 나온 실행 보고서고요.
2024년 고객용 AI 서비스로 국내 통신사 최초 ISO/IEC 42001 인증을 받았고, 이번 10월에는 사내 AI 에이전트 관리 체계로도 같은 인증을 추가로 받았습니다.
사내에 에이전트를 들였다면 모델 도입 심사만으로는 모자라는데, 에이전트를 자산으로 등록하고 폐기 단계의 권한 회수까지 담당자와 점검 항목을 사내 규정에 적어두는 쪽이 안전해요.
🔗 ZDNet Korea · 머니투데이 · 디지털데일리
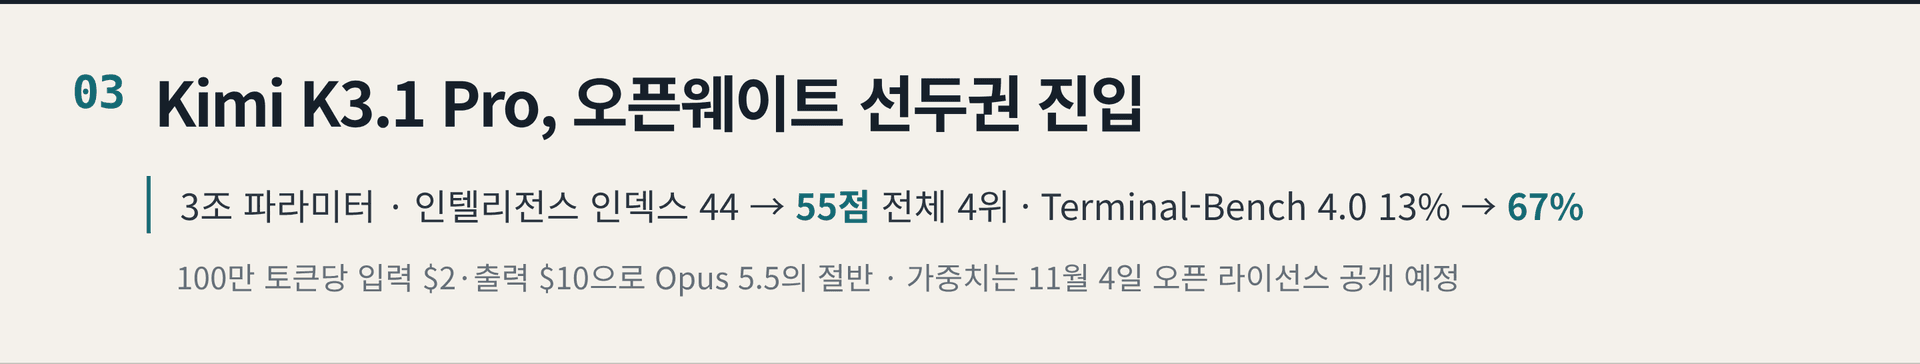
문샷의 Kimi K3.1 Pro가 오픈웨이트 선두권까지 올라왔어요. 🚀
7월에 공개된 K3를 후속 학습한 3조 파라미터 모델이고, 가중치는 11월 4일 오픈 라이선스로 풀 예정이라 그때까지는 앱과 API로만 씁니다.
Artificial Analysis 인텔리전스 인덱스가 44점에서 55점으로 올라 전체 4위고, Terminal-Bench 4.0은 13%에서 67%로 뛰었고요.
가격은 100만 토큰당 입력 2달러·출력 10달러로 Opus 5.5의 절반이고, 캐시된 입력은 0.2달러입니다.
다만 전 종목 우세는 아니어서 AutomationBench-AA는 73% 대 70%로 앞서지만 Humanity's Last Exam은 52% 대 61%, CritPt는 25% 대 32%로 밀립니다.
라이선스 조건이 아직 공개되지 않았으니, 사내 반입을 검토한다면 11월 4일 공개 문서를 보고 판단하는 편이 맞아요.
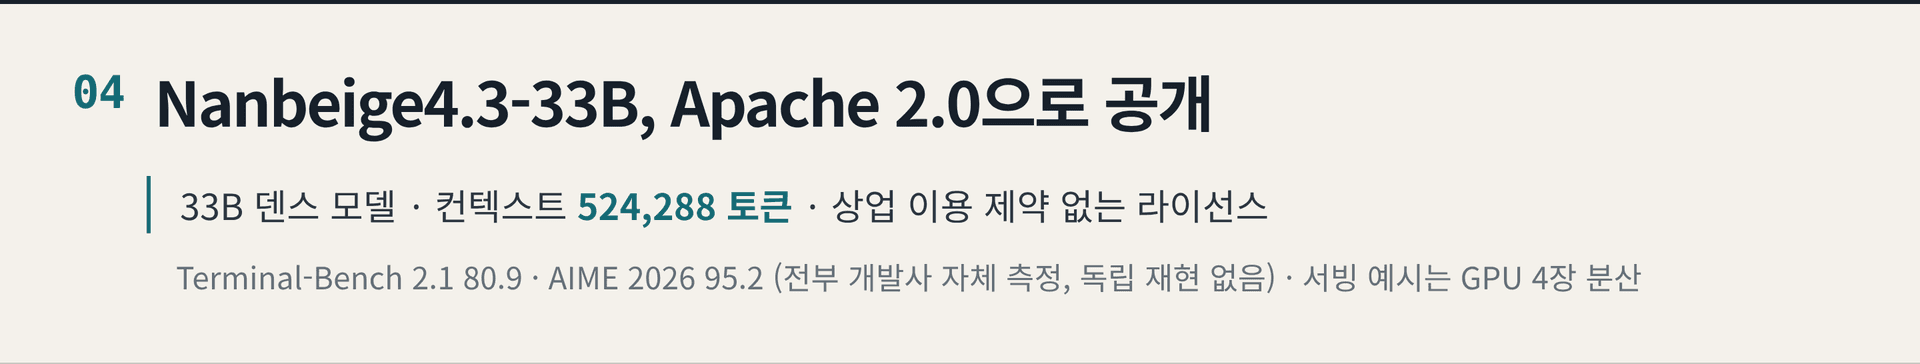
33B 오픈웨이트 코딩·에이전트 모델이 Apache 2.0으로 올라왔어요. 🧩
중국 채용 플랫폼 BOSS 즈핀의 Nanbeige LLM Lab이 주말 사이 허깅페이스에 Nanbeige4.3-33B를 공개했습니다.
컨텍스트가 524,288 토큰이고 추론이 기본으로 켜져 있고요, XML·JSON 툴 호출과 SGLang·vLLM 서빙을 지원합니다.
자체 측정으로 Terminal-Bench 2.1 80.9, DeepSWE 65.5, AIME 2026 95.2를 적어 Qwen3.8-27B·Muse-Glimmer-30B·Gemma4-31B를 대체로 앞선다고 했는데, SWE-Bench Pro와 GDPval은 Qwen 쪽이 더 높습니다.
수치가 전부 개발사 자체 측정이고 독립 재현이 아직 없다는 점은 같이 봐야 해요.
상업 이용 제약이 없는 라이선스라 사내망에 직접 올릴 선택지가 하나 늘었는데, 서빙 예시가 GPU 4장 분산이라 노트북 한 대로는 안 됩니다.
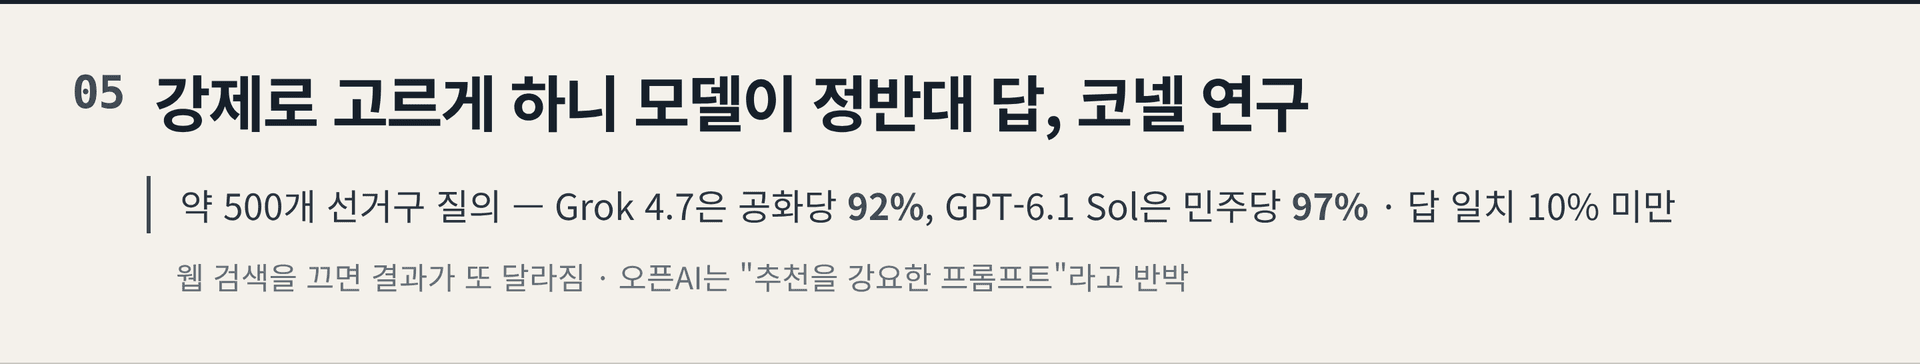
같은 질문에 모델이 정반대 답을 내놨다는 연구가 나왔어요. 🗳️
코넬대 교수 Tapan Parikh가 이끄는 Convovo가 미국 중간선거 약 500개 선거구를 두고 API로 "에두르지 말고 한 명만 고르라"고 물었습니다.
Grok 4.7은 92%에서 공화당 후보를, GPT-6.1 Sol은 97%에서 민주당 후보를 골랐고 둘의 답이 겹친 건 10%가 안 됐어요.
근거로 그록은 Ballotpedia·OpenSecrets·VoteSmart 같은 중립 사이트와 함께 보수 기독교 유권자 가이드를 39%, Turning Point Action을 23%, X를 41% 비중으로 인용했고 GPT는 위키피디아·AP·Axios·레딧을 봤습니다.
웹 검색을 끄고 30곳을 다시 물었더니 GPT는 24곳에서 여전히 민주당을 골랐고, 그록은 27곳에서 답을 거부하면서 고른 세 번은 전부 민주당이었고요.
오픈AI는 추천을 강요한 프롬프트로 개발자 API를 시험한 것이라 실제 사용 방식과 다르다고 반박했고, 그록을 만든 쪽은 기사 작성 시점까지 답하지 않았습니다.
판단이 걸린 업무라면 모델 하나의 답으로 끝내지 말고 복수 모델 교차 확인을 절차로 넣고, 웹 접근을 켰는지까지 기록해 두는 게 좋아요.
테크크런치 보도에 따르면 AI가 테크 업종 밖에서는 재무 성과를 못 내고 있다는 분석이 나왔어요. 📉
아폴로 글로벌 매니지먼트 수석이코노미스트 토르스텐 슬록이 낸 노트인데, S&P 500에서 알파벳·아마존·애플·메타·마이크로소프트·엔비디아·테슬라 7곳을 뺀 'S&P 493'을 봤습니다.
영업이익률과 직원 1인당 매출이 평평해서 AI가 생산성을 올렸다는 증거가 안 보인다는 내용이고요.
슬록은 기업에서 지능이란 대체로 판단이라, 값싼 AI를 매출과 이익률로 바꿀 수 있는지 자체가 의문이라고 적었어요.
원 노트는 아폴로 사이트에 올라간 자료고 정확한 발행일이 기사에 나오지 않아서, 수치보다 논지 쪽으로 읽는 편이 맞습니다.
도입 효과를 생산성 향상이라는 말로 뭉개서 보고하긴 어려워졌으니, 심사 단계에서 1인당 처리량·단위 비용 같은 측정 지표와 측정 주기를 먼저 정해두고 승인하는 쪽으로 기준을 바꿔볼 만해요.
금감원이 불법사금융 신고 38만 건을 AI로 엮어 '몸통'을 찾는 체계를 만들었어요. 🔍
피해 신고·제보·민원·불법 금융 광고 등 38만 건을 AI로 분석해, 따로 들어온 신고 사이의 고리를 찾아내는 방식입니다.
일당이 점조직으로 움직여서 신고를 건별로 처리하면 조직 범죄에 닿기 어려웠던 한계를 메우려는 거고요.
3월에 소비자경보가 나간 사채업자 '이실장' 조직은 새 체계로 다시 추적했더니 피해 규모가 당시 집계의 두 배를 넘었습니다.
정식 등록 대부업체가 불법 사채 영업을 도운 정황도 나와서, 대부업법 위반 소지가 큰 수십 곳을 추려 피해자 면담과 현장 점검에 들어가요.
고객 민원·신고 데이터를 다루는 쪽이라면 건별로만 쌓지 말고 교차 분석이 되는 형태로 적재하고, AI 분석 결과를 제재 단서로 넘길 때의 근거 기록과 재현 가능성을 사내 규정에 적어두는 게 안전합니다.
'모두의 AI' 이름을 국민 공모로 정합니다. 🇰🇷
과기정통부가 전 국민 무료 AI 서비스의 정책 브랜드명과 슬로건을 오늘부터 11월 6일까지 받아요.
브랜드명은 5자 이내, 슬로건은 20자 이내이고 의미와 기획 의도 설명 300자를 붙여 온라인으로 내면 됩니다.
심사 기준은 정책 적합성·활용 확장성·독창성·전달력이고, 수상작은 11월 16일 발표에 대상 200만원, 우수작 6점에 총 550만원이 걸려 있고요.
사업자는 8월 28일에 뽑힌 SKT·카카오·KT 3개 컨소시엄이고 정식 출시는 연내를 겨냥하고 있습니다.
전 국민 무료 AI가 깔리면 직원들이 쓰는 도구도 같이 바뀌니, 사내 AI 지침에 회사 데이터를 공공 무료 AI에 넣지 말라는 조항이 있는지 지금 점검해 두면 좋아요.
그록이 AI로 만든 '오디세이' 첫 7분을 내놨어요. 🎬
Grok Imagine으로 만들었고 Wonder Studios와 감독 Dev Walker가 함께했는데, 공개 게시물은 10월 23일에 올라왔습니다.
석 달쯤 전 일론 머스크가 역사적으로 정확한 전체 버전을 내겠다고 말한 뒤 나온 첫 결과물이고요.
테크크런치 리뷰어는 예상보다 덜 흉하고 일부 컷은 실사로 보일 만큼 다듬어졌다고 봤습니다.
다만 서사와 인물에 끌릴 대목이 없어서 절반도 못 가 시계를 봤고, 7분을 더 볼 생각은 안 든다고 적었어요.
사내 영상에 AI를 넣을 계획이라면, 7분 넘는 연속 서사가 필요한 포맷은 아직 사람 몫으로 남겨두는 기준점으로 쓸 만합니다.
증권사가 AI에게 주문 권한을 열어준 날과, AI가 테크 업종 밖에서는 성과를 못 냈다는 분석이 같은 주말에 나왔어요.
여러분 회사에서는 AI에게 '조회'를 넘어 '실행'까지 맡겨 본 일이 있나요? 💬