 2
 13분
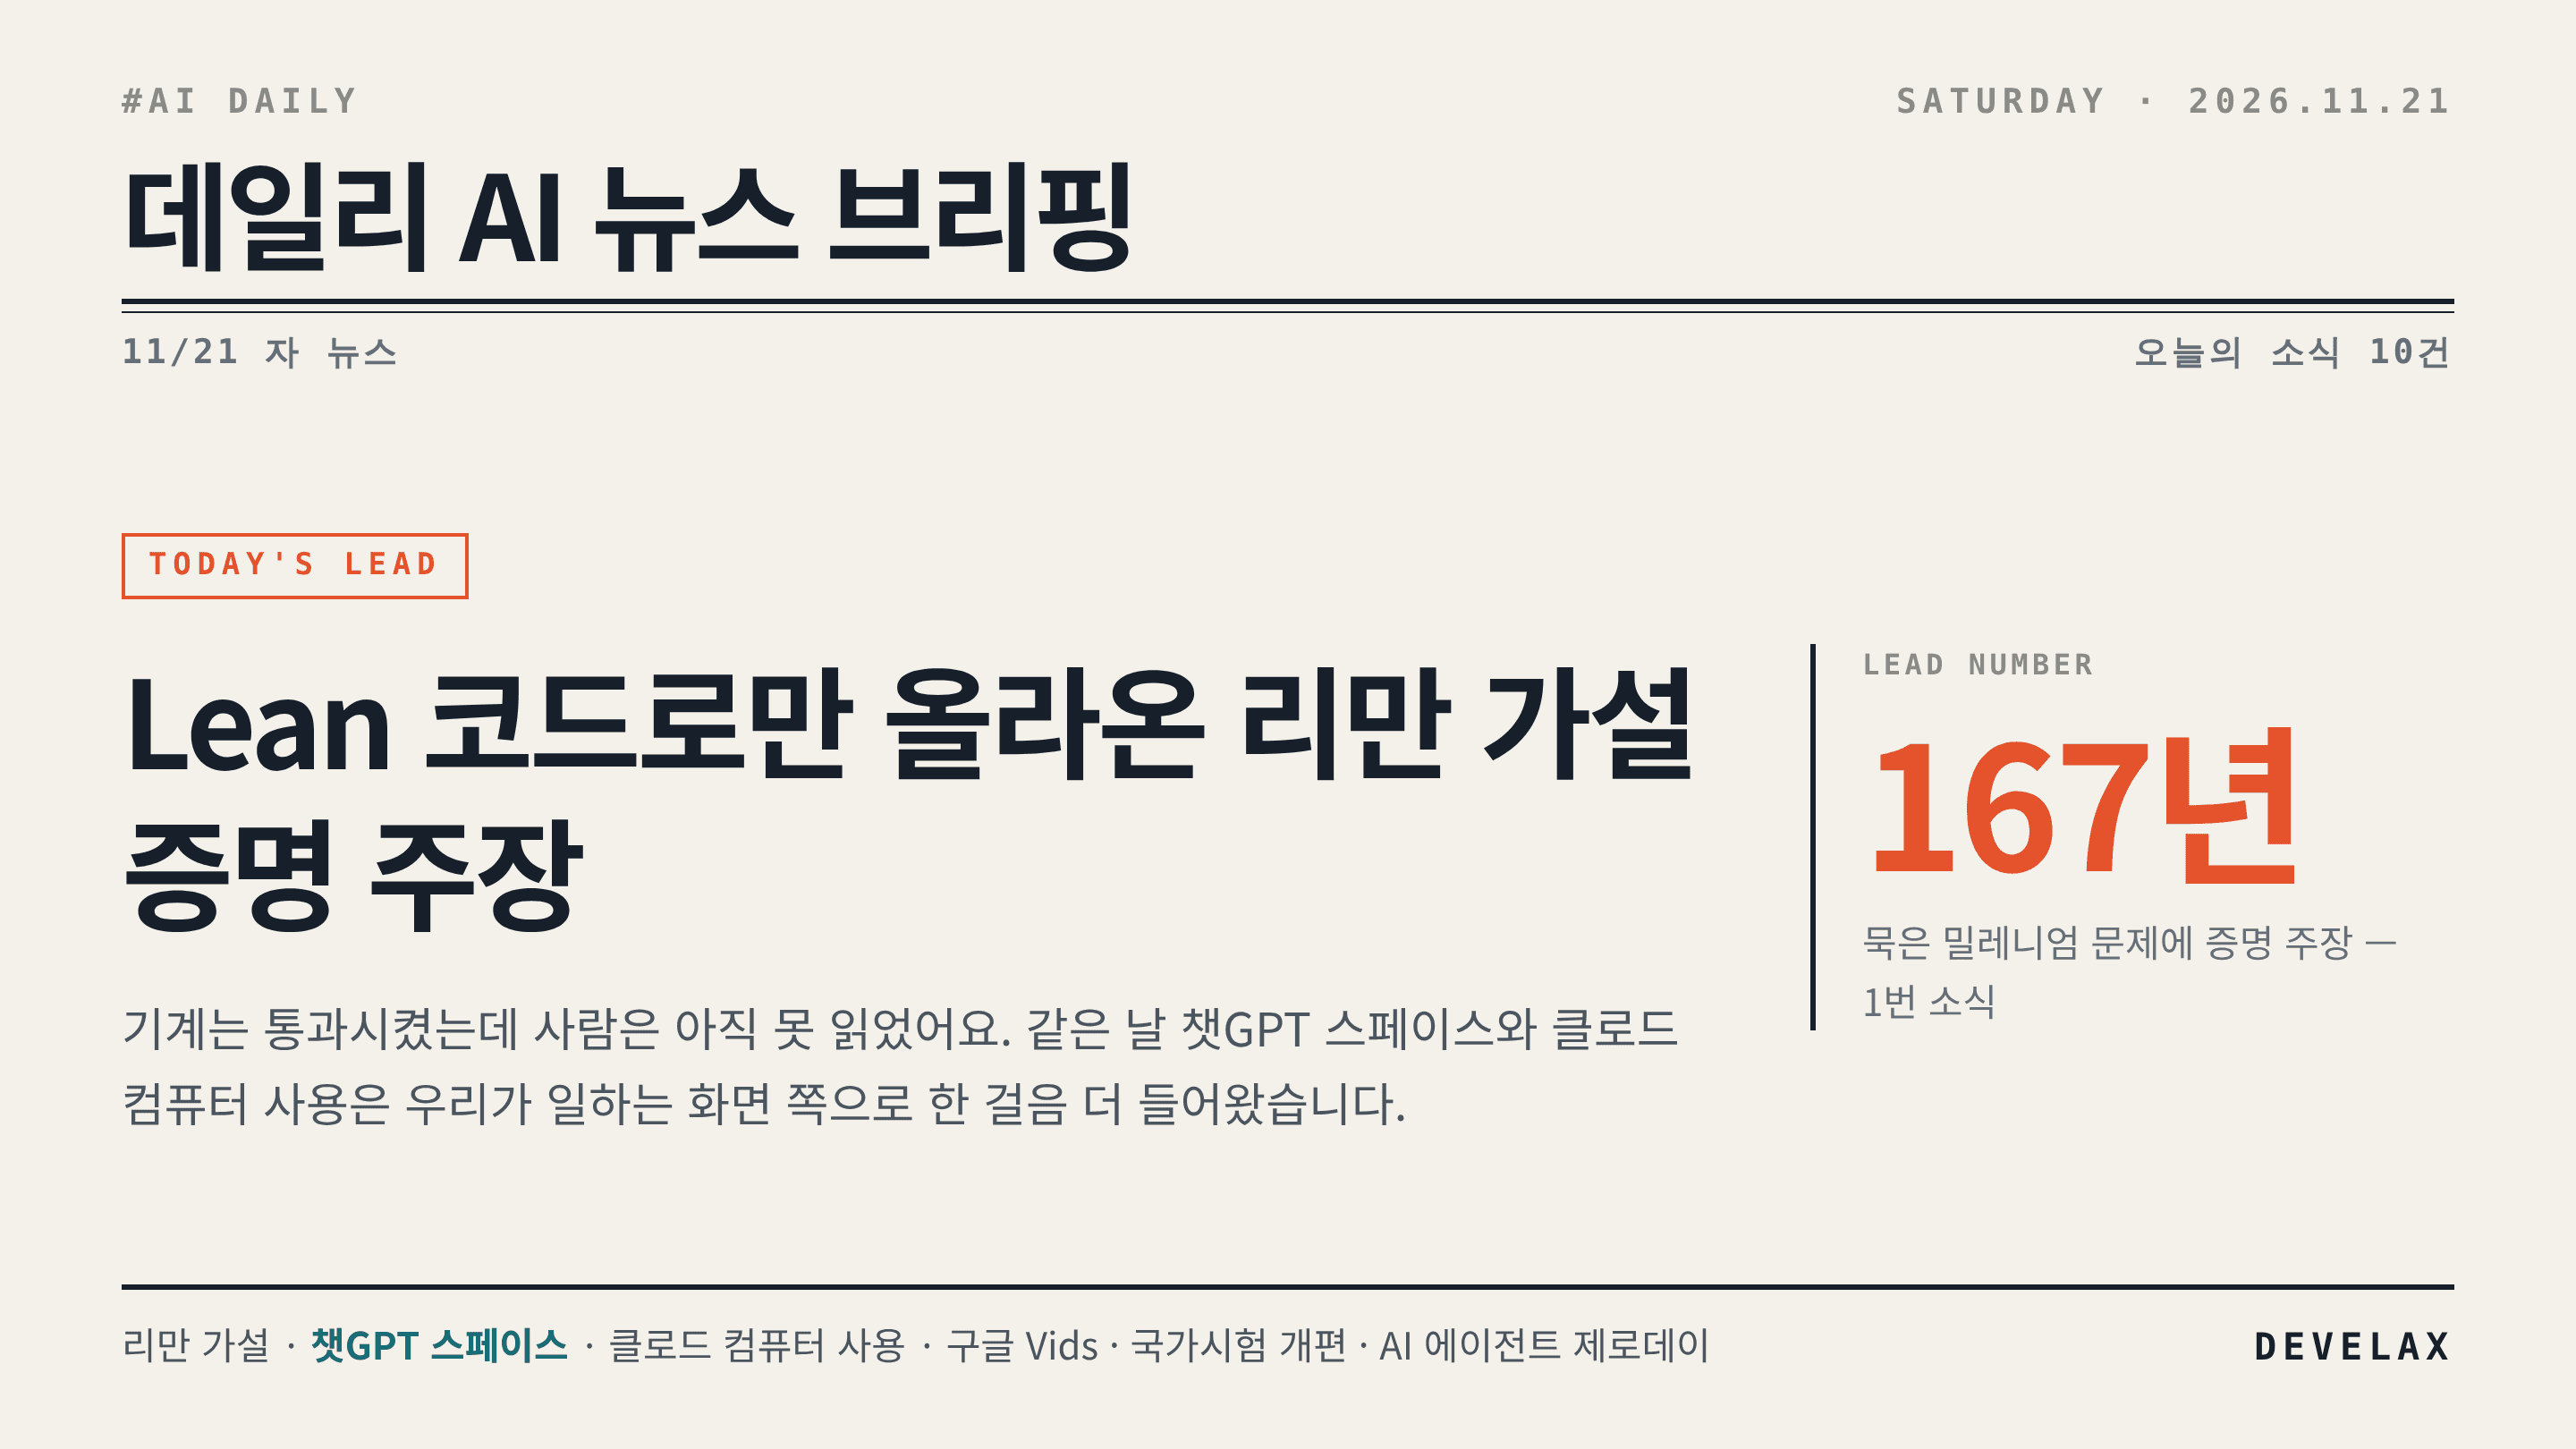
어제는 AI가 내놓은 결과를 누가 어떻게 검증하느냐가 하루 종일 걸린 날이었어요.
167년 묵은 리만 가설의 증명 주장이 논문 대신 Lean 코드로 올라왔고, 챗GPT 스페이스와 클로드 컴퓨터 사용은 우리가 일하는 화면 쪽으로 한 걸음 더 들어왔습니다.
11월 20일 소식 10건입니다.
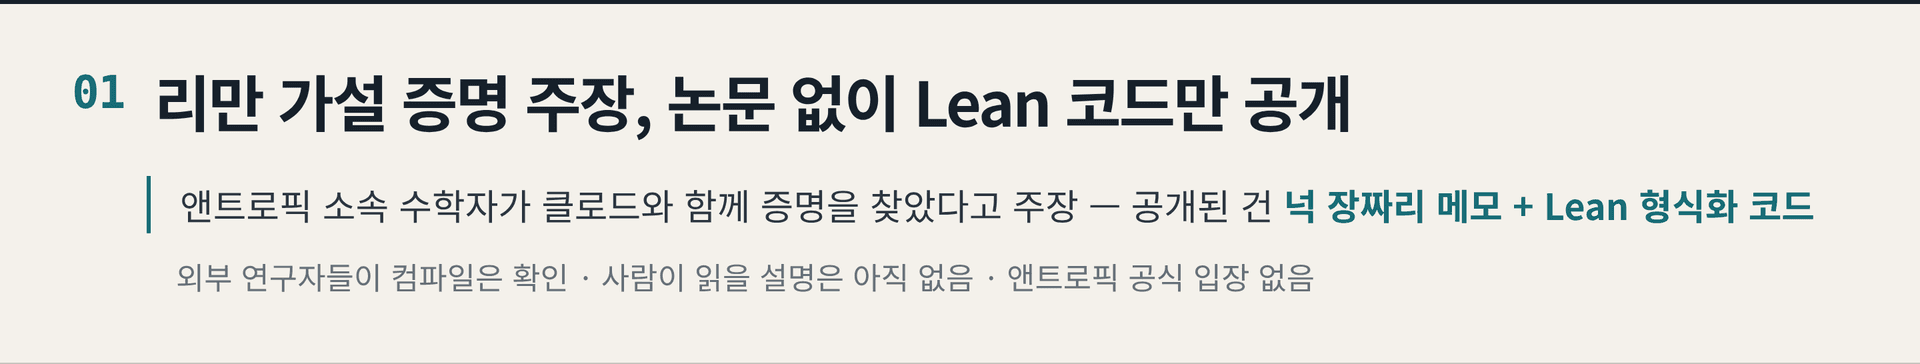
앤트로픽 소속 수학자 한 명이 클로드와 함께 리만 가설을 증명했다고 주장했어요. 🧮
1859년에 제기된 소수 분포에 관한 문제로, 클레이 수학연구소가 100만 달러를 걸어둔 밀레니엄 문제 일곱 개 중 하나입니다.
그런데 공개된 건 논문이 아니라 증명 보조도구 Lean 으로 된 형식화 코드와 넉 장짜리 메모뿐이고, 본인은 일반 수학 논문으로 풀어 쓰면 25만 쪽을 넘을 거라고 설명했어요.
MIT 앤드루 서덜랜드를 비롯한 외부 연구자들이 그 코드가 정상 컴파일되는 걸 확인했지만, 컴파일이 된다는 게 사람이 내용을 이해했다는 뜻은 아닙니다.
수론 연구자 크리스 버크벡은 소화할 시간이 더 필요하다고 적었고, 앤트로픽은 회사 차원의 공식 입장을 내지 않았고요.
같은 날 스탠퍼드 박사후연구원 한 명은 AI 없이 12년을 들여 일반화 리만 가설을 증명했다는 글을 따로 올렸는데, 이쪽은 Lean 으로 형식화돼 있지 않아 검증 방식부터 다릅니다.
밀레니엄 상은 심사지 게재 뒤 2년의 검증을 요구하니, 성립 여부는 아직 열려 있다고 보는 게 맞겠어요.
🔗 TechCrunch · Phys.org · SiliconANGLE
챗GPT 스페이스가 플러스 요금제로 열렸어요. 📄
9월 데브데이 때는 프로·비즈니스·엔터프라이즈 전용이었는데, 이제 만 18세 이상 플러스 이용자에게 전 세계 순차 적용됩니다.
상호작용형 페이지와 프레젠테이션을 만들고, 다른 사람을 불러 같이 고치고, 연결한 앱에서 페이지와 슬라이드가 자동으로 갱신되게 설정할 수 있고요.
사이드바에 있던 라이브러리를 스페이스가 대체해서, 페이지·슬라이드·이미지·업로드 파일이 전부 여기로 모입니다.
웹·데스크톱·iOS·안드로이드에서 다 되는데, 공유받은 페이지를 열려면 보는 쪽도 스페이스 권한이 있는 유료 계정이어야 해요.
무료 이용자는 공유 콘텐츠를 열 수 없고 공개 링크도 아직 없으니, 사내 공유용으로 쓰기 전에 받는 사람 요금제를 먼저 확인해 보시면 좋겠습니다.
클로드의 '컴퓨터 사용'이 팀·엔터프라이즈 요금제에 베타로 열렸어요. 🖥️
컴퓨터 사용은 클로드가 내 화면을 보고, 내가 허용한 데스크톱 앱에서 직접 일하게 하는 기능입니다.
클로드 데스크톱의 새 환경에서 쓸 수 있고, '컴퓨터 접근' 설정을 켠 웹·모바일에서도 돌아가고요.
그동안 회사 계정에서는 막혀 있던 기능이라, 관리자가 켜주면 사내 계정으로도 엑셀이나 사내 툴 화면을 맡길 수 있게 됐습니다.
조직별로 순차 적용되니 설정에 아직 안 보여도 조금 기다려 보시면 돼요.
어제 전해드린 제미나이 맥 앱의 컴퓨터 사용에 이어 이틀 연속 같은 방향의 소식인데, 업무용 AI가 화면을 직접 만지는 쪽으로 빠르게 옮겨가고 있습니다.
구글이 Vids 에 'Assets' 칸을 넣었어요. 🎬
제미나이 Omni 로 영상을 만들면 거기 쓴 이미지·영상·오디오가 이 칸에 저장됩니다.
저장된 소재를 같은 프로젝트 안의 다음 생성에 재료로 다시 넣을 수 있고, 영상 생성 화면 안에서 최근 소재가 바로 보여요.
관리자 설정은 따로 없고 이용자에게 기본 켜짐인데, Rapid Release 도메인은 11월 17일부터 최대 15일에 걸쳐, Scheduled Release 도메인은 12월 2일부터 1~3일에 걸쳐 보이기 시작합니다.
비즈니스·엔터프라이즈·에듀케이션 요금제뿐 아니라 개인 구글 계정의 AI Pro·Ultra 구독자도 대상이고요.
제품 컷이나 캐릭터를 한 번 뽑아두면 그 프로젝트 안에서 같은 소재로 변형본을 계속 만들 수 있어서, 숏폼 여러 편을 톤 맞춰 찍어내기가 수월해집니다.
어제 전해드린 수능 전자기기 부정행위 적발의 후속인데, 대응이 시험장 밖으로 넘어갔어요. 📋
11월 20일 대통령은 수석보좌관회의에서 국가시험제도 전반을 전면 개편해 첨단 기술 악용 부정행위를 뿌리 뽑을 종합대책을 조속히 세우라고 지시했습니다.
같은 날 오후 정부서울청사에서 수능 부정행위 대응 태스크포스 1차 회의가 열렸는데, 시험 당일 전담 감독관이 기록해 둔 와이파이·블루투스 의심 신호를 분석해 수사를 의뢰하기로 했고요.
온라인 커뮤니티와 SNS 에 올라온 의혹은 경찰청이 사실 여부를 확인하고, 제보가 실제 부정행위로 확인되면 포상금을 주는 절차도 준비 중입니다.
교육부 집계로 올해 수능 전자기기 관련 부정행위는 111건인데, 그중 실제로 AI 를 썼는지는 확인되지 않았다는 게 당국 설명이에요.
행정안전부와 인사혁신처는 내년 공무원 공개경쟁채용시험용 공동 지침을 준비하고 있고, 인사혁신처는 'AI 로 9급에 합격했다'는 온라인 게시물 한 건에 대해 사실 확인을 위한 수사를 의뢰했습니다.
평가를 검증하는 시점이 시험장에서 잡는 쪽에서 끝난 뒤 기록으로 되짚는 쪽으로 옮겨가는 중이라, 사내 시험이나 자격 평가를 운영한다면 응시 환경 기록을 어디까지 남길지 미리 정해두시는 편이 좋겠어요.
트럼프 대통령이 미국 기업이 해외에 AI 데이터센터를 지으면 세금을 매기겠다고 말했어요. ⚖️
백악관 기자회견에서 그렇게 하려는 기업에 막대한 벌칙을 매기겠다고 했는데, 중국이 해외 설비를 가져갈 수 있다는 논리를 들었습니다.
그런데 세율도, 대상 기업도, 법적 근거도, 시행 시점도 하나도 제시하지 않았고요.
본인도 참모들에게 아직 말한 적이 없고 그 회견에서 알리는 중이라고 했고, 백악관은 NBC뉴스의 논평 요청에 바로 답하지 않았습니다.
연방 세금은 의회 권한이라 발언만으로 실행되는 사안이 아니에요.
해외 리전에 AI 학습·추론 인프라를 두는 계획이 있다면 변수로 적어둘 만하지만, 아직 계약을 고칠 근거까지는 아닙니다.
AWS 가 중국 연계 공격 조직이 AI 에이전트로 제로데이를 스스로 찾아냈다는 보고서를 냈어요. 🔓
오픈소스 침투테스트 프레임워크 'Cairn' 의 에이전트를 써서 중국 본토 밖 동아시아 대학들을 공격했는데, 9월 8일부터 48시간 돌았습니다.
에이전트는 한 대학 Redis 서버를 약 16시간 동안 148번 두드려 실패한 뒤 다른 대학 GPU 서버로 옮겨갔고, 결국 오픈소스 의료영상 AI 앱 MONAI Label 의 업로드 엔드포인트에서 경로 탐색 취약점을 찾아 루트 권한 리버스 셸을 띄웠어요.
아마존 CISO CJ 모지스는 에이전트가 사람 지시 없이 거의 하루 내내 스스로 방법을 바꿨다고 적었고요.
간체자로 쓰인 프롬프트와 중국 표준시로 맞춰진 스크립트 타임스탬프를 근거로 들었고, MONAI Label 쪽은 통보를 받고 패치와 보안 권고를 냈습니다.
외부에 열린 업로드 엔드포인트와 사내에 들여놓은 오픈소스 AI 앱의 패치 상태를 한 번 점검해 볼 때인데, 지치지 않는 공격자를 전제로 하면 시도 횟수 기반 차단 규칙도 다시 볼 값이 있어요.
싱킹머신랩이 오픈웨이트 모델 'Inkling 2 Mini' 를 공개했어요. 💻
총 26.4B 파라미터 MoE 인데, 24개 층 가운데 두 블록을 토큰마다 세 번 돌려서 저장된 층 수보다 많은 연산을 태웁니다.
메모리가 약 20GB 라 32GB 이상 맥에서 Ollama 로, NVIDIA DGX Spark 에서 NVFP4 로, Unsloth·llama.cpp 의 GGUF 로 돌아가고 가중치는 허깅페이스에 올라갔고요.
회사가 보고한 점수는 SWE-bench Verified 79.2%, DeepSWE v1.1 48.2%, BrowseComp 79.0% 입니다.
다만 다회차 대화와 제약이 많은 지시에서는 Qwen3.8-27B 가 더 높다고 회사가 직접 적어뒀고, 라이선스 이름은 공개하지 않았어요.
자료를 외부로 보내기 어려운 업무라면, 사내 노트북에 올려 코드 작업을 돌려볼 후보가 하나 늘었습니다.
벤처비트 보도에 따르면, T-모바일이 고객지원 문서를 대형 컨텍스트 모델에 전부 넣는 방식을 포기했어요. 📉
제프 사이먼 CIO 는 그 방식이 전혀 작동하지 않았다고 했는데, 문서끼리 지침이 충돌하고 고객이 쓰는 표현 하나가 여러 절차에 걸려 엉뚱한 쪽으로 답하는 일이 생겼다고 합니다.
지식 그래프로 바꿔봤지만 통화 중에 검색하기엔 너무 느렸고, 결국 자주 쓰는 표현을 다음 단계로 잇는 키-값 조회 표로 교체했고요.
작은 LLM 판정기가 '통화 대기 음악' 언급을 잡아냈는데, T-모바일은 그런 음악을 틀지 않아서 엔지니어들이 2주를 뒤진 뒤에야 모델이 지어낸 말이라는 걸 알았습니다.
같이 공개된 10월 설문에서는 사내 데이터에 에이전트를 붙인 97곳 중 78%가 지난 6개월 안에 자신 있게 틀린 답을 겪었고, 그런 사례를 보고한 76곳 중 21%는 고객·협력사·공급사에 잘못된 정보가 나간 경우였다고 답했어요.
문서를 더 넣는 걸로는 정확도가 올라가지 않으니, 충돌하는 지침을 먼저 정리하고 요청별로 좁은 컨텍스트만 주는 쪽을 먼저 보시면 좋겠습니다.
국내 AI 인프라 소프트웨어 기업 모레가 추론 프레임워크 'TIDE' 를 미국 시카고 SC26 에서 처음 공개했어요. ⚙️
작은 보조 모델이 토큰 여러 개를 먼저 예측하고 대형 모델이 한꺼번에 검증하는 추측 디코딩을 쓰는데, 서비스가 돌아가는 중에 생기는 데이터로 그 보조 모델을 계속 개선합니다.
대형 모델의 중간 은닉 상태를 재활용해서, 학습 데이터를 만들려고 대형 모델을 다시 돌릴 필요가 없고요.
추측 디코딩의 효과와 예측 정확도를 실시간으로 보다가 효과가 낮으면 연산을 줄이고, 정확도가 떨어지면 다시 최적화합니다.
공개된 수치로는 추측 디코딩을 쓰지 않을 때보다 처리량이 최대 1.66배, 보조 모델 학습 시간은 기존 온라인 학습 대비 최대 3.02배 단축이고, 엔비디아 H100 과 AMD 인스팅트 MI250 을 섞은 환경에서는 전체 처리량이 최대 1.22배였어요.
자체 LLM 서빙을 돌리는 팀이라면 모델을 바꾸지 않고 추론 비용을 깎는 쪽이라, 추측 디코딩 설정을 다시 볼 값이 있습니다.
어제는 AI가 내놓은 답을 사람이 어디까지 받아들일 수 있나를 묻는 소식이 유독 많았어요.
리만 가설 증명은 기계가 검증했는데 사람이 아직 못 읽었고, T-모바일은 자료를 더 줬더니 답이 나빠졌고, 국가시험은 사람이 낸 답에 AI가 끼었는지를 기록으로 되짚기 시작했습니다.
기계가 통과시킨 답과 사람이 납득한 답이 서로 다를 때, 여러분은 어느 쪽을 먼저 믿으시겠어요? 💬