 0
 14분
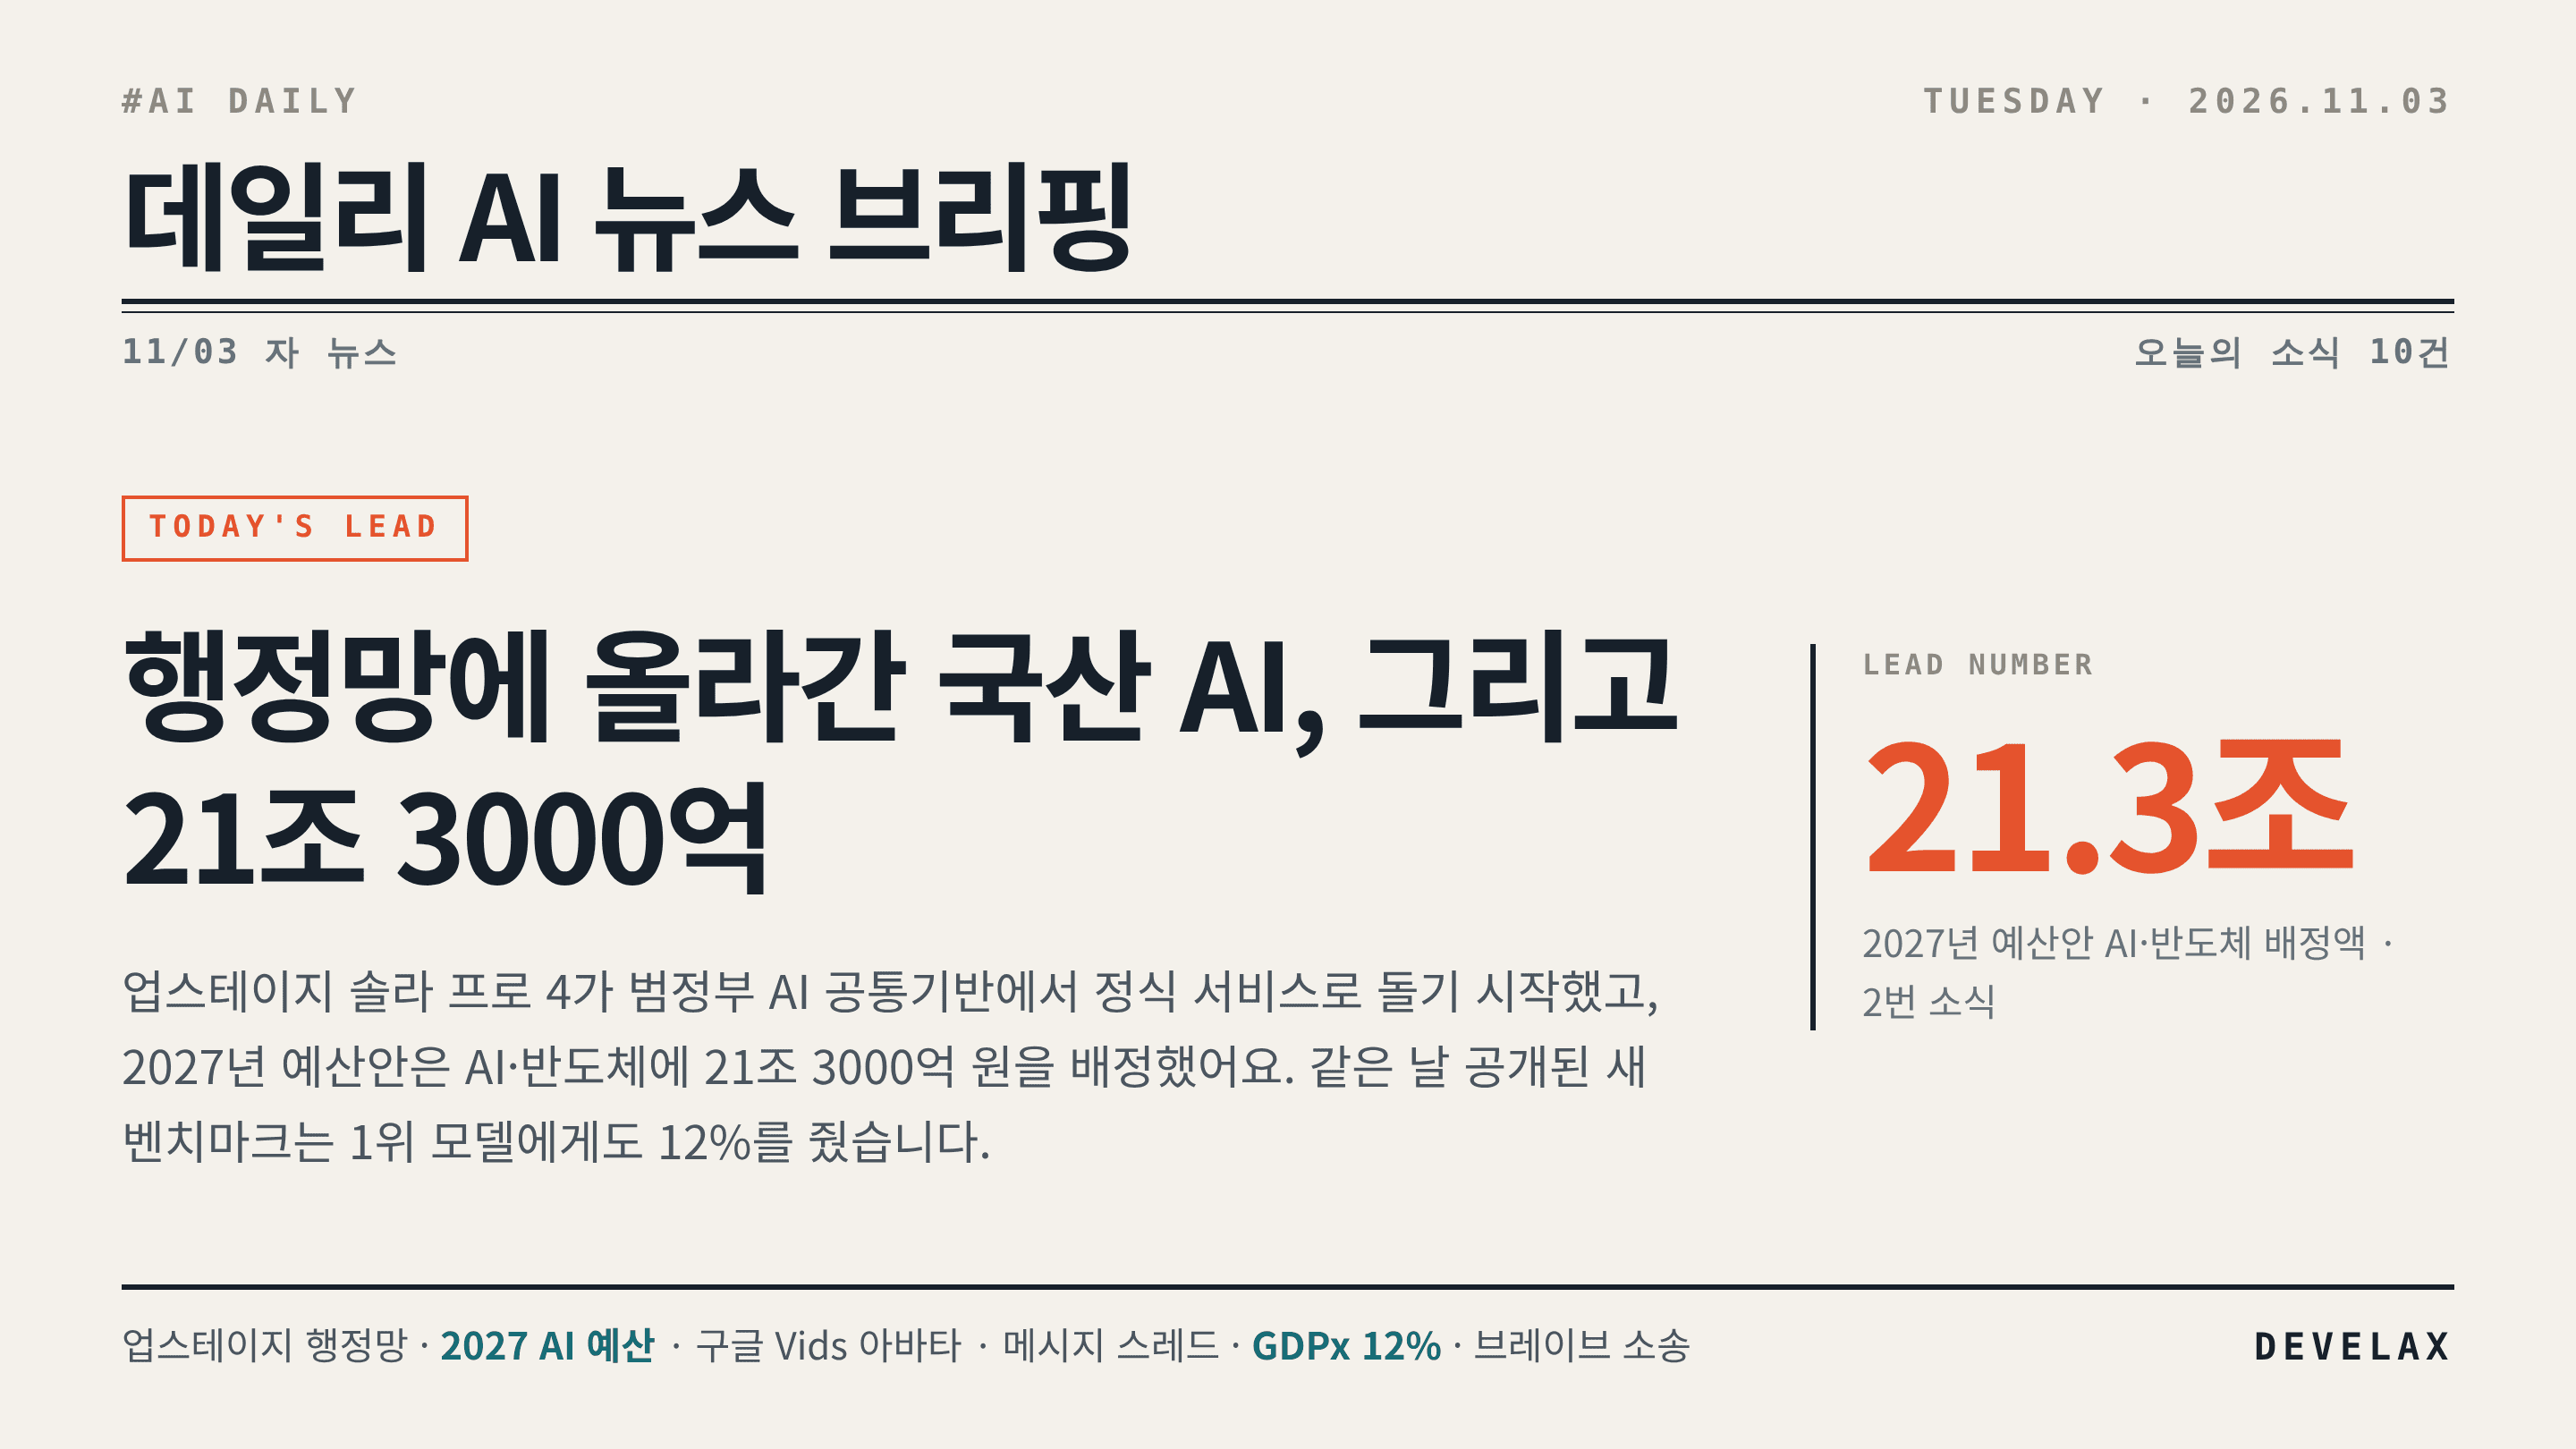
어제는 국내 소식이 앞에 섰어요 — 업스테이지 모델이 정부 행정망에서 정식 서비스로 돌기 시작했고, 2027년 예산안에서 AI·반도체에 21조 3000억 원이 배정됐습니다.
해외에서는 에이전트가 전문 업무를 얼마나 끝내는지 재는 새 벤치마크가 1위에게도 12%를 줬고, 뉴욕타임스는 브라우저 회사를 상대로 소송을 냈고요.
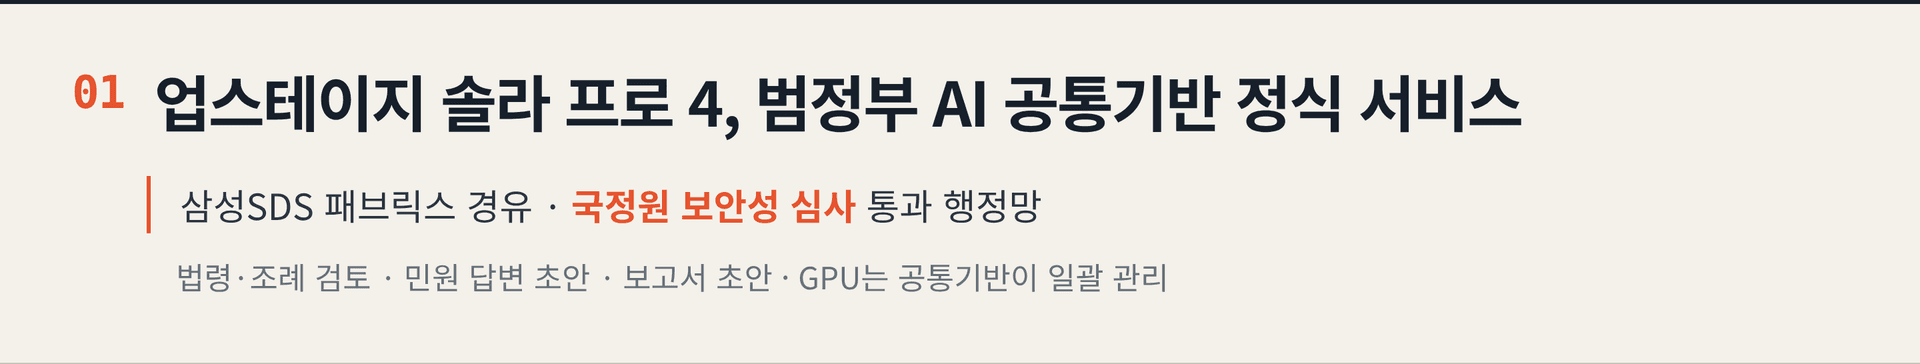
업스테이지가 자사 모델 솔라 프로 4를 범정부 AI 공통기반에 올려 정식 서비스를 시작했어요. 🏛️
공통기반은 행정안전부와 과학기술정보통신부가 중앙부처·지자체에 AI 모델과 개발 환경을 제공하는 행정망 전용 인프라인데, 삼성SDS 패브릭스를 거쳐 모델이 공급됩니다.
국가정보원 보안성 심사를 통과한 인프라에서 돌아가서 내부 행정 자료가 외부로 나가지 않고요, GPU는 공통기반이 일괄 관리하니 기관이 서버를 따로 사거나 빌릴 필요가 없습니다.
공무원이 쓸 업무로는 조례·규정이 상위법과 어긋나는지 검토하기, 민원 답변 초안, 회의록 기반 보고서 초안, 정책자료 요약이 제시됐어요.
답변에 근거가 된 법령과 행정자료를 함께 보여주는 방식이라, 생성형 도구를 공공 업무에 넣을 때 제일 걸리던 "근거를 못 댄다"는 문제를 정면으로 겨냥했습니다.
사내 규정 검토나 민원성 문의 응대를 자동화하려는 쪽이라면, 모델 성능보다 근거 표시와 망 분리 조건을 먼저 보는 이 구성을 참고할 만해요.
이재명 대통령이 2일 국회 시정연설에서 2027년 예산안을 설명하면서 AI·반도체에 21조 3000억 원을 넣겠다고 밝혔어요. 💰
올해보다 두 배 가까운 규모인데, 반도체·피지컬 AI·AI 데이터센터를 3대 메가프로젝트로 묶었습니다.
세부로는 반도체 생산기반 2조 원, 8대 핵심 분야 피지컬 AI 현장 실증 5000억 원, 전력·용수·산단 인프라 2조 1000억 원이고요.
독자 AI 모델을 국가전략 자산으로 보고 프런티어 AI 개발 사업에 4조 7000억 원을 집중한다고 적었고, 국가 R&D 예산은 역대 최대인 39조 5000억 원입니다.
공공서비스를 찾아주고 신청까지 돕는 '모두의 AI' 공공 AI 에이전트 사업도 함께 시작해요.
다만 21조 3000억 원은 반도체를 포함한 묶음 수치이고 아직 국회 심의 전 정부안이라, 확정액은 달라질 수 있습니다 — 피지컬 AI 실증과 프런티어 AI 과제는 내년 공고로 바로 이어질 돈이니 참여를 볼 기업은 지금 준비해 두는 편이 좋아요.
🔗 지디넷코리아 · 대한민국 정책브리핑 · 파이낸셜뉴스
구글 Vids에서 내 사진을 올려 AI 아바타를 만들 수 있게 됐어요. 🎬
전에는 아바타를 처음부터 디자인해야 했는데, 이제 PC·구글 드라이브·구글 포토에서 이미지를 가져와 바로 만듭니다.
Vids 안에서 배경을 정리하거나 조명을 조정하고 장식을 더해 다듬을 수 있고, 만든 아바타는 프로젝트에 저장돼 영상에서 반복해 씁니다.
비즈니스 스타터·스탠다드·플러스와 엔터프라이즈 스타터·스탠다드·플러스, 에듀케이션 플러스가 대상이고, 구글 AI 프로·울트라를 쓰는 개인 계정도 됩니다.
신속 배포 도메인은 10월 30일부터 순차 적용됐고 예약 배포 도메인은 11월 20일부터인데, 관리자 제어 항목이 없다고 공지에 적혀 있어요.
사내 교육이나 공지 영상을 촬영 없이 만들던 쪽은 한 단계 쉬워졌지만, 관리자가 끌 수 없는 기능이라 얼굴 이미지 사용 기준을 사내에서 먼저 정해두는 게 좋겠습니다.
앤트로픽이 메시지 스레드를 퍼블릭 베타로 열었어요. ⚡
긴 에이전트 세션에서 매 턴 대화 전체를 다시 올리지 않아도 되게 만든 API 기능인데, 첫 요청으로 스레드를 만들고 이후에는 새 메시지와 직전 응답 ID만 보냅니다.
50만~100만 토큰 요청에서 첫 토큰까지 걸리는 시간이 중간값으로 약 35% 줄었다고 앤트로픽이 밝혔고요.
대신 Claude는 매 턴 대화 전체를 읽기 때문에 토큰 사용량과 요금은 그대로입니다 — 빨라지는 건 체감 지연이지 비용이 아니에요.
스레드 내용은 메모리에만 암호화해 두고 디스크에 쓰지 않으며 마지막 요청 뒤 5분이면 만료되고, 늦어도 1시간 안에 삭제되는데 ZDR 구성에는 적용되지 않습니다.
Claude Code는 기본으로 켜져 있어 따로 할 일이 없고, 직접 API를 붙인 팀은 스레드가 만료돼 404가 돌아올 때 전체 대화를 다시 보내는 경로를 남겨둬야 해요.
🔗 앤트로픽 공식 발표 · 공식 문서
세미애널리시스가 에이전트 능력을 재는 새 벤치마크 GDPx를 공개했는데, 1위 점수가 12%였어요. 📉
반도체 설계·사이버보안·생물학·금융·법률·퀀트 트레이딩 등 11개 전문 영역 과제로 짰고, 14곳의 전문 데이터 파트너와 함께 만들었습니다.
Claude Opus 5.5가 12.0%로 1위, Gemini 4 Carbon이 10.9%, GPT-6 Astra가 9.6%였고요.
세미애널리시스는 Opus 5.5와 GPT-6 Astra가 자체 안전 분류기 때문에 사이버·생물학·정렬 과제에서 막히는 경우가 있어 총점이 깎였다고 밝혔고, 그 세 영역을 뺀 순위도 따로 냈습니다.
채팅 벤치마크 점수가 90%대로 올라가 있어도 실제 전문 업무를 처음부터 끝까지 맡기면 아직 10%대라는 뜻이에요.
에이전트 도입을 검토하는 쪽이라면 맡길 범위를 좁게 잡고 사람 검수를 전제로 설계하는 근거로 써볼 만합니다.
메이투안이 1.6조 파라미터 멀티모달 에이전트 모델 LongCat-2.5를 공개했어요. 🐱
토큰당 활성 파라미터는 약 480억인 MoE 구조이고, 이미지와 텍스트를 하나의 토큰 체계에서 받아 시각 코딩·디자인·3D 작업을 겨냥했습니다.
긴 작업 시퀀스 학습과 대규모 강화학습으로 복잡한 코드베이스를 끝까지 다루는 능력을 올렸다고 적었고요.
지금은 메이투안 채팅 서비스와 API로 쓸 수 있고, 깃허브·허깅페이스 공개는 예정 단계라 가중치는 아직 나오지 않았습니다.
메이투안이 내놓은 다른 모델과의 비교 수치는 자체 발표라 독립 재현 결과가 없으니, 숫자는 일단 보류하고 읽는 게 맞아요.
중국 쪽 에이전트 코딩 모델이 이 규모로 계속 나오면 개발 도구의 모델 선택지가 넓어지니, 벤더 비교표를 갱신할 시점입니다.
오픈AI가 데이터센터 전력을 전력망 사정에 맞춰 줄이는 '그리드 프로텍터스' 프로그램을 공개했어요. 🔌
앞으로 짓는 컴퓨트 캠퍼스가 지역 전력망이 빠듯할 때 스스로 사용량을 낮추는 방식이고, 감축 폭·속도·지속 시간은 지역 전력사와 개별 협상입니다.
첫 적용지는 조지아주 에핑햄 카운티의 3.2GW 캠퍼스로, 조지아파워가 피크 때 최대 1,000MW를 줄일 수 있게 25년 계약을 걸었고 조지아 공익사업위원회가 8월에 승인했고요.
캠퍼스에 필요한 송전선과 전기 공급 비용은 오픈AI가 전액 부담한다며, 가정과 소상공인이 컴퓨트 캠퍼스의 전기 수요를 보조해야 할 이유는 없다고 적었습니다.
배터리와 전력 제어로 수요 변동을 고르게 만들고, 일부 지역에서는 자체 발전·저장 설비로 전력망에 거꾸로 공급하는 방안도 넣었어요.
오픈AI 스스로 유연성이 발전소와 송전선을 대신할 수는 없다고 단서를 달았는데, 국내 AI 데이터센터 입지·전력 협상에서도 '수요 감축 약정'이 조건으로 올라올 수 있는 선례입니다.
🔗 오픈AI 공식 발표 · The Next Web · Unite.AI
뉴욕타임스가 브라우저 회사 브레이브를 맨해튼 연방법원에 제소했어요. ⚖️
같은 날 뉴욕데일리뉴스·시카고트리뷴·올랜도센티널도 같은 취지로 소송을 냈습니다.
소장은 브레이브가 발행사가 막을 수 없는 크롤러로 300억 페이지 넘는 색인을 만들었고, 그 데이터를 앤트로픽·퍼플렉시티·미스트랄·xAI·코히어에 넘겼다고 적었고요.
페이월을 우회하는 브라우저 기능과 발행사 광고를 차단하면서 자사 광고를 파는 방식도 쟁점으로 올렸고, 뉴욕타임스는 브레이브를 "훔친 저작물의 공급자·판매자·유통자"라고 불렀습니다.
브레이브는 보도 시점에 입장을 내지 않았어요.
AI 학습이나 검색 데이터를 외부 인덱스 사업자에게서 사오는 조직이라면, 공급계약서에 출처 적법성 보증과 면책 조항이 있는지 확인하고 도입 심사표에 데이터 조달 경로 항목을 따로 넣어둘 때입니다.
🔗 TechCrunch · Search Engine Journal
튀르키예 경쟁당국이 구글의 AI 개요와 AI 모드를 시장지배적 지위 남용 혐의로 조사하기 시작했어요. 🇹🇷
이용자가 정보를 찾는 방식이 바뀌면서 발행사 트래픽이 빠지는지, 뉴스사와 맺은 콘텐츠 이용 계약에 불공정한 조건이 있는지, 발행사와 경쟁 AI 챗봇을 배제하는 효과가 있는지를 봅니다.
예비 검토에서 차별적·착취적 소지에 '강한 의심' 단계까지 갔다고 보고 임시조치도 함께 걸었고요.
임시조치는 발행사 사이에 차별이 없는 조건을 만들 것, 쓰는 콘텐츠의 경제적 가치를 반영할 것, 발행사가 AI 개요·AI 모드 포함 여부를 따로 고를 수 있게 하고 그 선택이 일반 검색 색인·노출에 불이익으로 돌아오지 않게 할 것입니다.
위반 결론이 난 것도, 기능을 금지한 것도 아니라는 점은 분명히 해둘 대목이에요 — 구글은 올해 2월 튀르키예에 두 기능을 넣었습니다.
자사 콘텐츠가 AI 검색 요약에 쓰이는 기업은 '검색 색인 동의'와 'AI 요약 표시 동의'를 분리해 관리하는 조항을 플랫폼 약관 검토 목록에 더해둘 만합니다.
🔗 Türkiye Today · Hürriyet Daily News · Daily Sabah
평범해 보이는 AI 앱 400여 개가 성적 딥페이크 생성기를 숨겨두고 있었다고 WIRED가 보도했어요. 🚨
앱과 연결 도메인 400여 개가 하나로 묶여 있고 중국의 한 조직이 만든 것으로 보인다는 내용인데, 겉으로는 어학 교습이나 반려동물 사진 앱처럼 보입니다.
서버 검사를 거쳐 특정 조건이 맞으면 성적 이미지·영상을 만드는 웹 화면을 몰래 띄우는 구조고요, 메타 플랫폼의 딥페이크 광고를 눌러 내려받은 경우가 작동 조건 하나로 지목됐습니다.
애플은 심사 시점에는 규정을 지켰고 이후 개발자가 콘텐츠를 가져오는 사이트를 바꿨다고 설명하며 19개를 내렸고, 같은 앱들이 구글 플레이에도 올라가 있었습니다.
메타는 관련 도메인과 연결된 광고 계정 1만 개 이상에 조치했다고 밝혔어요.
사내 모바일 앱 허용 목록을 '스토어 심사 통과' 하나로만 관리하면 이런 사후 변조를 못 잡으니, 업무용 단말 정책에 설치 뒤 동작 변경 점검과 생성형 앱 차단 기준을 넣어둬야 합니다.
🔗 9to5Mac · AppleInsider
정부는 독자 AI 모델에 4조 7000억 원을 걸었는데, 같은 날 공개된 벤치마크는 제일 잘하는 모델도 전문 업무를 12%밖에 끝내지 못한다고 알려줬어요.
여러분은 AI에게 맡긴 일의 결과를 어떤 기준으로 검수하고 계신가요? 💬